Phân quyền dữ liệu là mảng rủi ro AI mà nhiều doanh nghiệp chỉ để ý tới khi đã muộn. Trong danh sách 10 rủi ro hàng đầu của các ứng dụng dùng mô hình ngôn ngữ AI do OWASP công bố năm 2025, việc lộ thông tin nhạy cảm đứng thứ hai, với một kịch bản rất đời thường: người dùng hỏi AI một câu và nhận về dữ liệu cá nhân của người khác.
Ở Việt Nam, đây còn là chuyện pháp lý, vì Luật Bảo vệ dữ liệu cá nhân đã có hiệu lực từ ngày 01/01/2026. Tuy vậy, AI vẫn thường được đánh giá qua việc trả lời có trôi chảy hay không. Một câu trả lời trôi chảy không cho biết AI đã đọc dữ liệu nào, đọc thay cho ai và lấy từ bản nào. Phần lớn câu trả lời đều đúng nên niềm tin tăng rất nhanh, trong khi những lỗi còn lại trông y hệt câu trả lời đúng: một con số gộp lẫn hai chi nhánh, một mức chiết khấu theo chính sách năm ngoái, hay một thông tin lương đến tay người ngoài phòng nhân sự.
AI thông minh hơn không làm việc kiểm soát khó hơn; điều làm khó là nối AI vào dữ liệu khi chưa có quy định rõ ràng. Bài viết phân tích ba lớp cần kiểm soát, cách phân quyền dữ liệu theo vai trò và mục đích, ba rủi ro thường gặp (rò rỉ, sai ngữ cảnh, vượt quyền) và bốn quyết định quản trị nên làm rõ trước khi nối AI vào dữ liệu của công ty.
Ba lớp cần kiểm soát: dữ liệu, cách ghép câu trả lời và hành động
Mỗi câu trả lời của AI đều đi qua ba lớp. Mỗi lớp có thể hỏng theo một cách riêng, nên cũng cần một cách kiểm soát riêng. Nếu gộp chung cả ba, doanh nghiệp dễ sửa nhầm chỗ.
1. Dữ liệu
Những gì AI đọc được: tài liệu, đơn hàng, công nợ, bảng lương. Câu hỏi ở lớp này là phạm vi và độ mới: đã đúng dữ liệu chưa, có phải bản đang áp dụng không, và người đang hỏi có được xem không?
2. Cách ghép câu trả lời
Cách AI tìm những mảnh thông tin liên quan và ghép chúng lại. Dữ liệu đúng vẫn có thể cho ra câu trả lời sai nếu AI ghép số liệu của hai phòng ban hoặc của hai kỳ khác nhau.
3. Hành động
Những gì diễn ra sau câu trả lời: có người làm theo, hoặc AI soạn thảo, ghi nhận một việc. Lớp này gắn với quyền quyết định và phê duyệt.
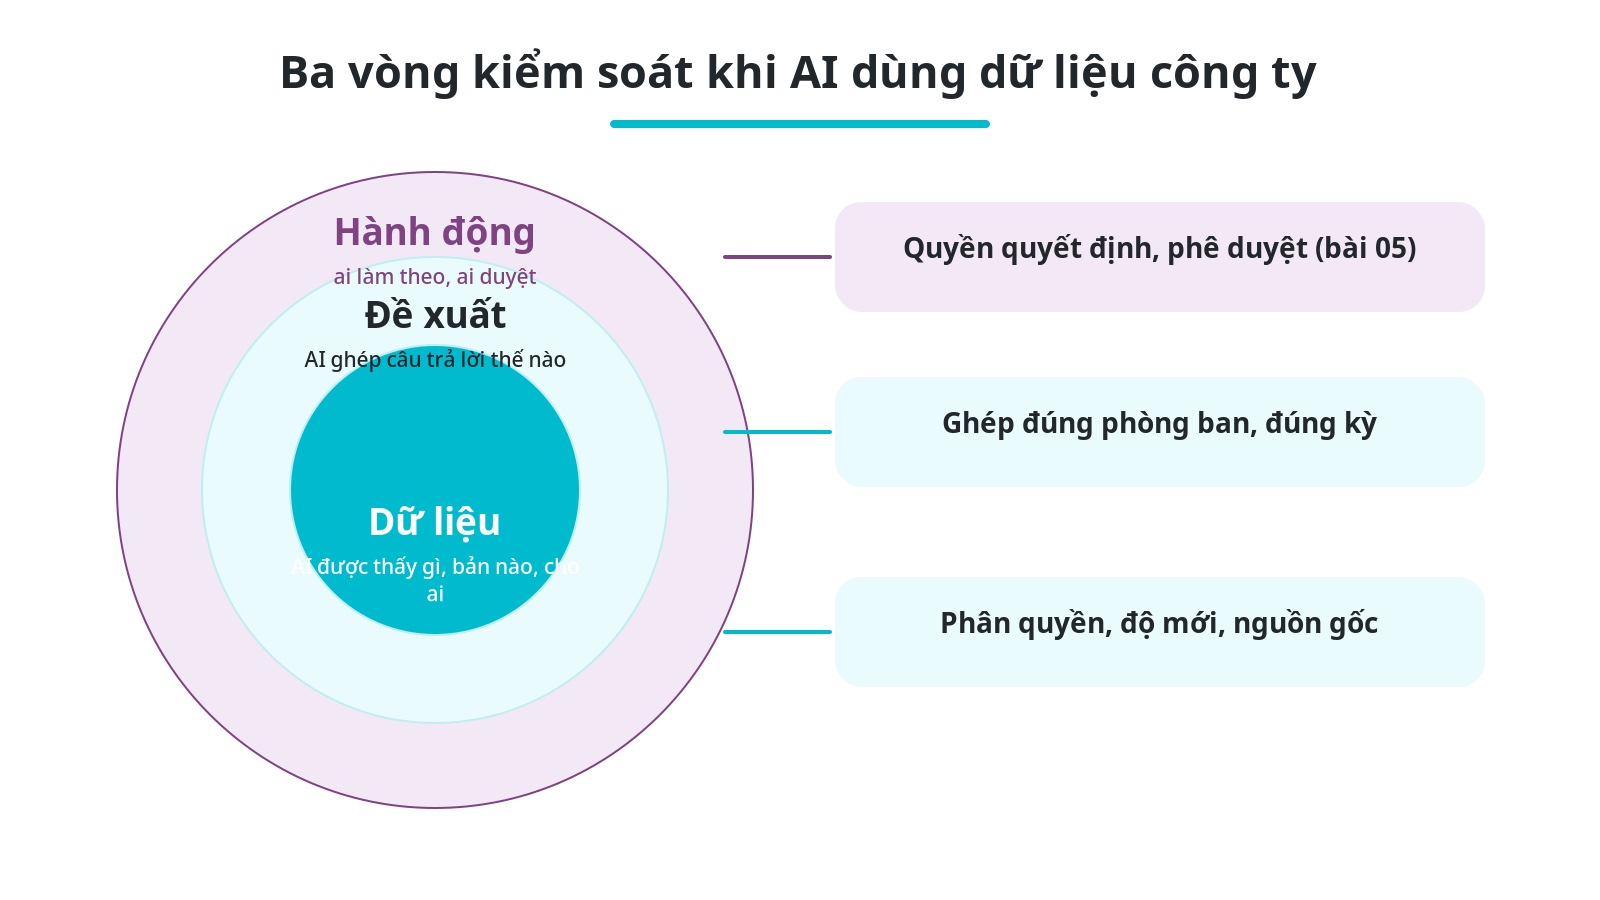
Mỗi vòng cần một cách kiểm soát riêng. Câu trả lời tốt ở vòng giữa không bù được chỗ hở ở vòng ngoài.
Bài viết này chỉ bàn hai lớp đầu. Giới hạn hành động, ai phê duyệt và ai chịu trách nhiệm đã được phân tích ở bài trước, AI làm sai, ai chịu trách nhiệm?
Dấu hiệu thường gặp: khi trợ lý AI được nối vào dữ liệu bán hàng và kế toán, hai giám đốc thường kéo về hai phía. Giám đốc kinh doanh muốn AI thấy càng nhiều càng tốt, để nhân viên bán hàng có đủ câu trả lời về giá, tồn kho, công nợ khách hàng mà không phải chờ kế toán. Kế toán trưởng lại muốn giá vốn, hạn mức công nợ và điều khoản với nhà cung cấp chỉ đến tay người thực sự cần. Trong khi đó, lỗi vẫn trông y như câu trả lời đúng: công nợ quá hạn cộng lẫn số của chi nhánh vào trụ sở, hay một mức chiết khấu đã được thay từ đầu năm. Cả hai giám đốc đều có lý. Chỗ hở nằm ở việc chưa ai quyết định cách phân quyền dữ liệu cho AI: dữ liệu nào, cho ai, theo bản nào.
Hai lỗi này nằm ở hai lớp khác nhau. Cộng số chi nhánh vào trụ sở là lỗi ở khâu ghép câu trả lời. Trích dẫn chính sách cũ là lỗi ở lớp dữ liệu. Vì thế, hướng dẫn nhân viên "hỏi cho chính xác hơn" không sửa được lỗi nào.
Ba lớp này ít quan trọng hơn khi AI chỉ đọc tài liệu công khai, như danh mục sản phẩm. Chúng quan trọng nhất ở những nơi câu trả lời đi thẳng vào báo giá, khoản chi hay thư trả lời khách hàng.
Phân quyền dữ liệu theo vai trò và theo mục đích
Câu hỏi đầu tiên cần đặt ra với bất kỳ trợ lý AI nào khá đơn giản: khi đọc dữ liệu của công ty, nó dùng quyền của ai? Có hai cách làm phổ biến, và mỗi cách dẫn tới một mức rủi ro rất khác.
| AI đọc dữ liệu theo cách nào | Điều xảy ra | Rủi ro |
|---|---|---|
| Bằng một tài khoản riêng có quyền rộng | Ai hỏi được AI cũng chạm được tới mọi thứ tài khoản đó nhìn thấy | Một cửa sau đi vòng qua quy định phân quyền của công ty |
| Bằng đúng quyền của người đang hỏi | Mỗi người chỉ nhận câu trả lời từ dữ liệu mình vốn đã được xem | AI chỉ chặt chẽ đến mức bảng phân quyền hiện có cho phép |
Danh sách các rủi ro nghiêm trọng nhất của ứng dụng dùng mô hình ngôn ngữ lớn, do OWASP (một cộng đồng bảo mật phi lợi nhuận) duy trì, cũng khuyến nghị đúng như vậy: chỉ cấp quyền xem dữ liệu nhạy cảm ở mức tối thiểu cần thiết, để AI làm việc trong phạm vi quyền của người đang đăng nhập, và để hệ thống gốc kiểm tra quyền thay vì giao cho AI tự quyết. Nói theo ngôn ngữ quản trị: AI không nên được thấy nhiều dữ liệu hơn chính nhân viên mà nó đang hỗ trợ.
Tuy nhiên, chỉ dựa vào vai trò là chưa đủ; còn phải tính đến mục đích. Nhân viên kinh doanh được xem công nợ của khách để đi thu tiền, nhưng điều đó không có nghĩa là được xem công nợ của mọi khách hàng, hay của khách do đồng nghiệp phụ trách. Phân quyền dữ liệu tốt hỏi dữ liệu được dùng để làm gì, chứ không chỉ hỏi ai đang giữ chức danh gì.
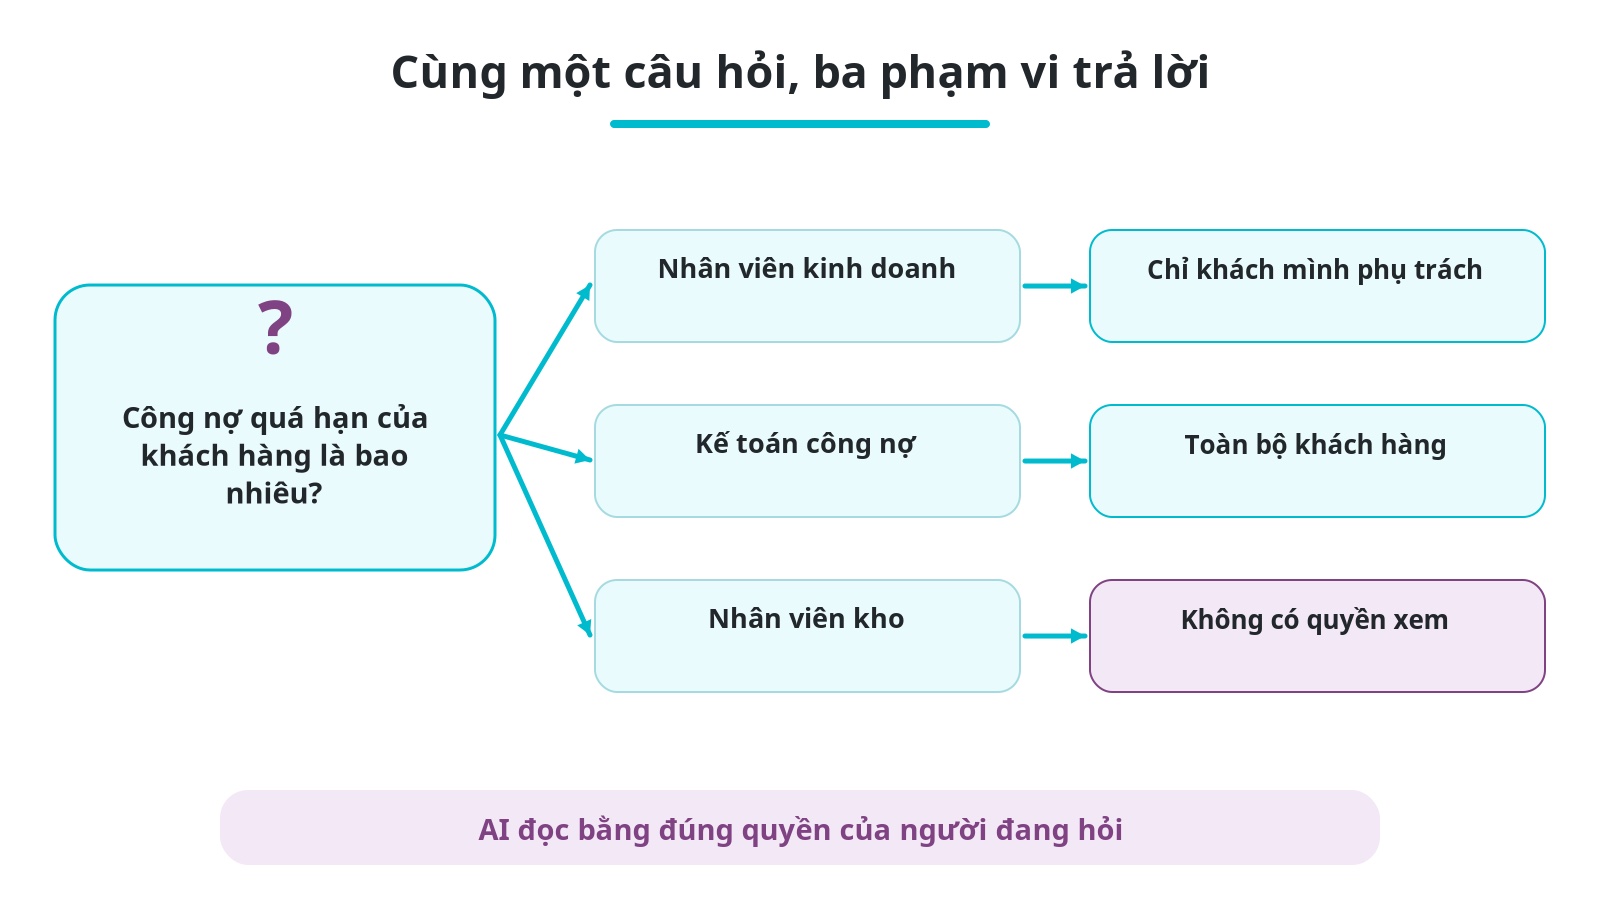
Cùng một câu hỏi, phạm vi dữ liệu trả về khác nhau tùy người hỏi là ai và hỏi để làm gì.
Có một hệ quả thứ hai mà CEO thường bỏ qua. Khi đọc bằng quyền của từng người, AI sẽ nhanh chóng phơi bày bảng phân quyền mà doanh nghiệp đang có. Nếu ai cũng xem được mọi thứ, chỉ vài ngày sau AI sẽ cho thấy điều đó, vì mọi người bắt đầu hỏi những câu trước đây họ chưa từng tự tra. AI không tạo ra lỗ hổng; nó chỉ làm lỗ hổng lộ ra. Vì vậy, việc đầu tiên của một dự án AI thường là rà soát lại phân quyền dữ liệu hiện có.
Dữ liệu phân tán khiến việc này khó hơn. Khi kinh doanh giữ một bảng tính, kế toán giữ một bảng khác, kho giữ bảng thứ ba, thì cùng một câu hỏi đã có ba câu trả lời: ba người, ba con số. AI nối vào cả ba tệp không phân xử được bên nào đúng, thậm chí có thể đưa ra con số thứ tư. Khi các phòng ban cùng làm việc trên một bộ dữ liệu chung, với một bộ quy định phân quyền, phần lớn vấn đề đã được gỡ trước khi AI xuất hiện. Đây không phải điểm riêng của nhà cung cấp nào; hầu hết hệ thống quản trị tích hợp đều được xây dựng theo cách này. Điều quyết định là doanh nghiệp có thực sự làm việc trên dữ liệu chung đó, hay mỗi người vẫn xuất ra tệp riêng của mình.
Ba tệp, ba con số: AI nối vào cả ba sẽ thừa hưởng luôn sự vênh nhau.
Sự đánh đổi ở đây là có thật. Phân quyền dữ liệu càng chặt thì AI càng hay trả lời "bạn không có quyền xem", và một số nhân viên sẽ thấy khó chịu. Sự khó chịu ấy chỉ ra chỗ quy định phân quyền chưa khớp với công việc thực tế; điều cần làm là xem lại quy định, chứ không phải tìm cách lách qua.
Phân quyền dữ liệu cần dữ liệu mới, đúng và có nguồn rõ ràng
AI không tự biết tài liệu nào đang có hiệu lực nếu không ai cho nó biết. Khi tra cứu tài liệu của công ty, AI chọn những đoạn khớp nhất với câu hỏi, chứ không phải đoạn mới nhất hay đoạn đã được duyệt. Nếu chính sách chiết khấu năm ngoái và năm nay cùng nằm trong một thư mục, AI có thể trích bất kỳ bản nào, với cùng một vẻ chắc chắn.
Hướng dẫn của OWASP nói thẳng điều này: dữ liệu gộp từ nhiều nguồn có thể mâu thuẫn với nhau, và AI có thể không để thông tin mới thay thế những gì nó đã có. Viện Tiêu chuẩn và Công nghệ Quốc gia Mỹ (NIST), trong bộ hướng dẫn năm 2024 về rủi ro của AI tạo sinh, xếp "bịa đặt" (confabulation) thành một rủi ro riêng: nội dung sai nhưng được nói bằng giọng chắc chắn, dễ khiến người dùng hiểu sai. Nguồn đã cũ càng làm loại câu trả lời này khó bị phát hiện, vì đứng sau nó là một tài liệu có thật.
Dữ liệu mà AI sử dụng cần đi kèm ba thuộc tính:
- Độ mới: con số này được cập nhật lần cuối khi nào? Tồn kho, công nợ đọc trực tiếp từ giao dịch khác với một báo cáo xuất ra từ tuần trước.
- Hiệu lực: tài liệu này còn được áp dụng không, và bản đã bị thay thế đã được gỡ ra hoặc đánh dấu rõ chưa?
- Nguồn gốc: câu trả lời lấy từ bản ghi hay tài liệu nào, để một người có thể kiểm tra lại trong chưa đầy một phút?
Dữ liệu đi thẳng từ giao dịch nghiệp vụ vốn đã luôn mới: đơn hàng, hóa đơn, phiếu thu chính là bản ghi gốc. Điểm yếu nằm ở các tài liệu và tệp được giữ bên ngoài hệ thống. Cách giữ cho tài liệu quy trình luôn có người phụ trách và luôn được cập nhật đã được phân tích ở bài thứ tư của loạt bài, AI học hết quy trình rồi, doanh nghiệp còn cần người giỏi?
Văn bản không ghi ngày hiệu lực thì AI không có cách nào phân biệt bản cũ với bản mới.
Ba rủi ro khi phân quyền dữ liệu lỏng: rò rỉ, sai ngữ cảnh và vượt quyền
Rủi ro khi nối AI vào dữ liệu công ty có thể chia thành ba nhóm. Mỗi nhóm có nguyên nhân khác nhau, nên cách kiểm soát cũng khác nhau.
Rò rỉ
AI đưa dữ liệu cho người không được phép xem. OWASP mô tả một trường hợp điển hình: người dùng nhận được dữ liệu cá nhân của người khác ngay trong câu trả lời. Nguyên nhân là AI đọc bằng quyền rộng hơn quyền của người hỏi.
Sai ngữ cảnh
Dữ liệu đúng, được phép xem, nhưng bị dùng sai chỗ: số liệu của chi nhánh xuất hiện trong câu trả lời về trụ sở. OWASP cảnh báo nguy cơ ngữ cảnh bị lẫn giữa các nhóm người dùng chung một kho dữ liệu.
Vượt quyền
AI chạm tới được hoặc làm được nhiều hơn mức nhiệm vụ cần. OWASP gọi đây là quyền tự hành quá mức: quá nhiều chức năng, quá nhiều quyền và quá ít bước phê duyệt độc lập.
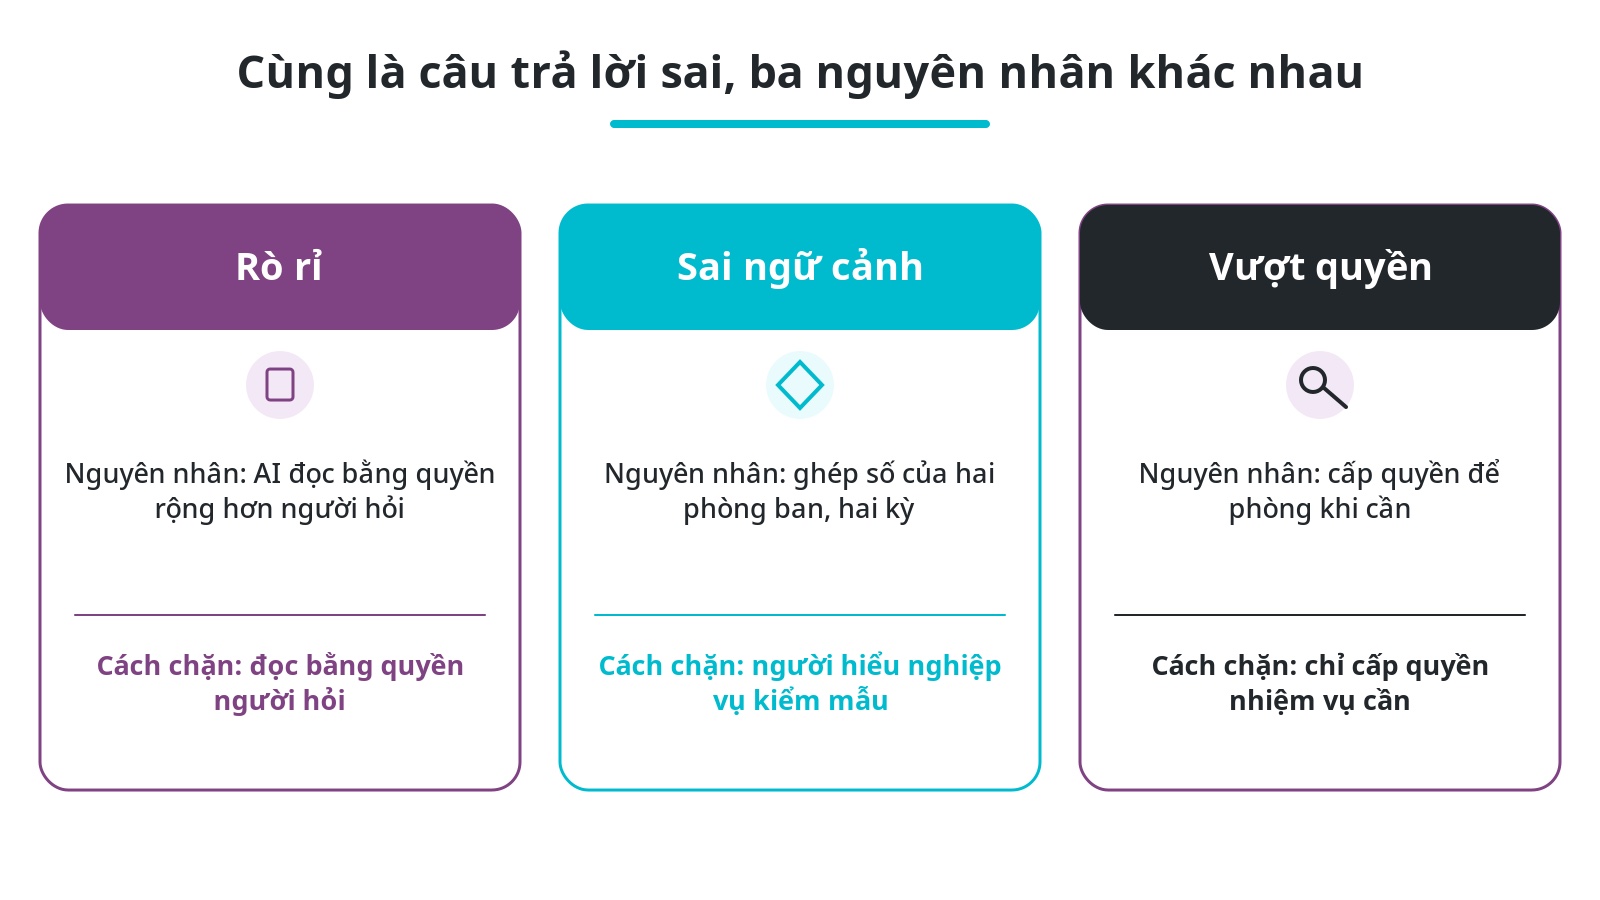
Cùng một biểu hiện là câu trả lời sai, nhưng có ba nguyên nhân khác nhau và ba cách sửa khác nhau.
Rò rỉ là rủi ro dễ nhận thấy nhất, và cũng là chuyện pháp lý. Ở Việt Nam, Luật Bảo vệ dữ liệu cá nhân (số 91/2025/QH15) có hiệu lực từ ngày 01/01/2026. Những thông tin về nhân viên và khách hàng như lương, số giấy tờ tùy thân, địa chỉ, hồ sơ sức khỏe đều là dữ liệu cá nhân. Nếu AI đưa các dữ liệu đó cho sai người, thì về bản chất vẫn là doanh nghiệp để lộ dữ liệu. NIST tách quyền riêng tư dữ liệu và an toàn thông tin thành hai rủi ro riêng của AI tạo sinh, bên cạnh rủi ro bịa đặt; mỗi rủi ro cần một cách kiểm tra riêng.
Sai ngữ cảnh khó thấy nhất, vì không có quy định nào bị vi phạm: con số nào cũng có thật và đều được phép xem. Chỉ người hiểu nghiệp vụ mới nhận ra. Vượt quyền gắn với lớp hành động, đã bàn ở bài trước; riêng với phân quyền dữ liệu, điều cần giữ hẹp hơn: không nên cấp cho AI quyền xem "để phòng khi cần".
Ai phát hiện câu trả lời sai: nhật ký, tỷ lệ lỗi và trường hợp từ chối
Câu trả lời sai của AI trông giống hệt câu trả lời đúng, và người hỏi thường lại là người khó phát hiện lỗi nhất, vì họ hỏi chính bởi họ chưa biết. Do đó, việc phát hiện lỗi cần được thiết kế như mọi khâu kiểm soát nội bộ khác.
Bộ hướng dẫn về AI tạo sinh của NIST yêu cầu tổ chức có kế hoạch giám sát sau khi đưa AI vào sử dụng, gồm cách ghi nhận phản hồi của người dùng, cách khiếu nại và ghi đè kết quả, cách xử lý sự cố, và giám sát riêng rủi ro bịa đặt. Với một doanh nghiệp trăm người, việc này không cần đến một đội giám sát riêng. Điều cần là bốn tín hiệu, và mỗi tín hiệu có một người phụ trách:
| Tín hiệu | Cho biết điều gì | Ai xem |
|---|---|---|
| Nhật ký: ai hỏi, AI đã đọc dữ liệu nào, trả lời gì | Giúp lần ngược mọi phản ánh về tận nguồn | Người phụ trách dự án AI, khi có vụ việc |
| Kiểm mẫu hằng tháng | Tỷ lệ trả lời sai trên câu hỏi thật, theo từng mảng | Người phụ trách từng mảng dữ liệu: kinh doanh, kế toán, nhân sự |
| Trường hợp từ chối: "bạn không có quyền xem" | Quy định phân quyền có hoạt động không, và chỗ nào chưa khớp công việc thực tế | Người đặt phân quyền |
| Phản ánh câu trả lời sai từ nhân viên | Những lỗi không ai khác thấy | Người phụ trách mảng dữ liệu, có phản hồi lại cho người báo |
Lỗi được phát hiện bởi người hiểu nghiệp vụ, với điều kiện có người giao cho họ việc đó.
Các trường hợp từ chối đáng được chú ý riêng. Một tháng không có lần từ chối nào không hẳn là tin tốt; thường điều đó có nghĩa là AI đang thấy quá nhiều. Nếu số lần từ chối ở một phòng ban tăng đột ngột, thì hoặc quy định đang quá chặt so với công việc, hoặc có người đang tìm dữ liệu ngoài vai trò của mình. Cả hai điều này đều không thể thấy được nếu các lần từ chối không được ghi lại.
Thói quen quan trọng nhất lại ít tốn kém nhất: mỗi phản ánh của nhân viên về câu trả lời sai đều được phản hồi rằng đã sửa những gì. Nếu phản ánh rơi vào im lặng, người ta sẽ thôi báo, và tỷ lệ lỗi doanh nghiệp nhìn thấy giảm xuống trong khi tỷ lệ lỗi thật thì không.
Tiện lợi và an toàn là một lựa chọn, không phải một nút cài đặt
Mỗi biện pháp kiểm soát nêu trên đều lấy đi một chút tiện lợi: nhiều lần từ chối hơn, phải có người quyết định tài liệu nào đã cũ, phải có người đọc nhật ký. Cám dỗ thường gặp là cấp quyền rộng cho AI trước rồi siết lại sau. Trên thực tế, "siết lại sau" thường chỉ đến sau sự cố đầu tiên.
Lối ra là phân quyền dữ liệu theo từng nhóm, chia theo cái giá phải trả nếu xảy ra sai sót:
| Nhóm dữ liệu | Ví dụ | Điểm xuất phát hợp lý |
|---|---|---|
| Công khai hoặc dùng chung nội bộ | Danh mục sản phẩm, quy trình chung, lịch nghỉ lễ | Mở rộng; kiểm tra độ mới |
| Nhạy cảm về kinh doanh | Giá vốn, biên lợi nhuận, hạn mức công nợ, điều khoản nhà cung cấp | Chỉ theo quyền của người hỏi; kiểm mẫu hằng tháng |
| Dữ liệu cá nhân | Lương, số giấy tờ tùy thân, hồ sơ sức khỏe, thông tin liên hệ của khách | Quyền hẹp nhất; ghi nhật ký mọi lần đọc; có nghĩa vụ pháp lý |
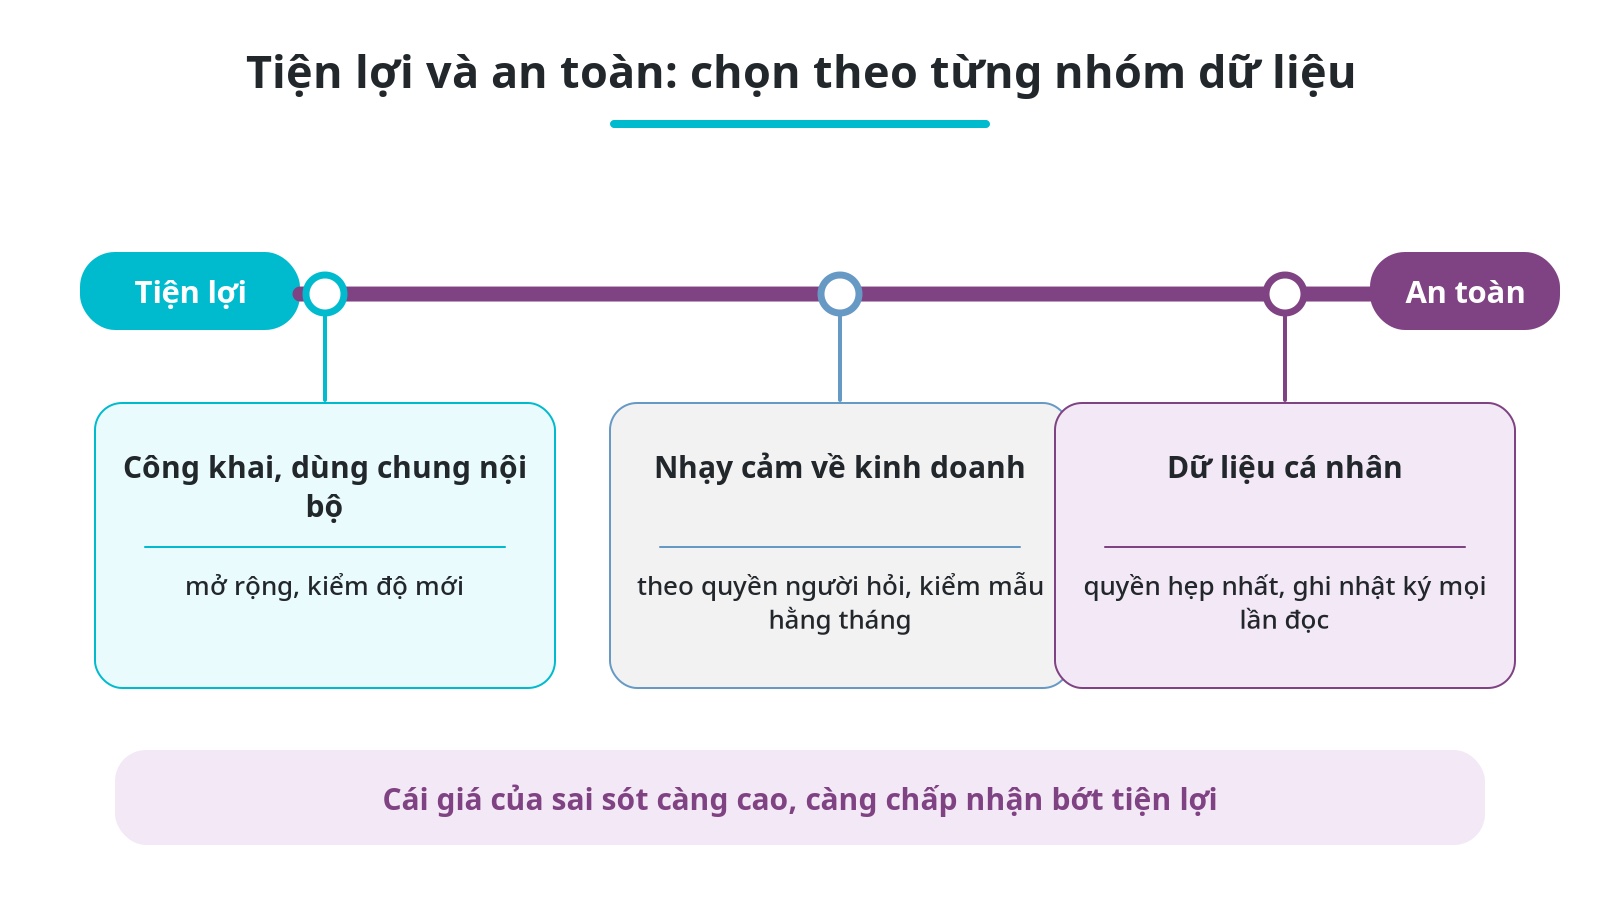
Cái giá của sai sót càng cao, doanh nghiệp càng nên chấp nhận bớt đi sự tiện lợi.
Khung quản lý rủi ro AI của NIST nêu một điểm mà CEO nên ghi nhớ: các phẩm chất của một hệ thống AI đáng tin cậy thường kéo nhau theo nhiều hướng, và một hệ thống dù bảo mật, kín đáo, minh bạch nhưng trả lời sai thì vẫn không dùng được. Bảo mật, độ chính xác và trách nhiệm là ba câu hỏi khác nhau. Một "điểm an toàn AI" chung sẽ che mất câu hỏi nào đang có vấn đề.
Bốn quyết định quản trị để phân quyền dữ liệu cho AI
Phân loại dữ liệu và đặt quyền theo vai trò
Chia dữ liệu thành vài nhóm theo cái giá phải trả nếu sai. Với mỗi nhóm, quyết định ai được xem và xem để làm gì. Để AI đọc bằng quyền của người đang hỏi, và rà soát lại phân quyền hiện có trước khi đưa AI vào dùng.
Kiểm nguồn và hiệu lực tài liệu
Mỗi tài liệu AI sử dụng đều có người phụ trách và ngày hiệu lực. Bản đã bị thay thế được gỡ ra hoặc đánh dấu rõ. Câu trả lời ghi rõ lấy từ đâu, để việc kiểm tra chỉ mất một phút chứ không mất cả buổi.
Giới hạn hành động và mức phê duyệt
Chỉ cấp cho AI những quyền mà nhiệm vụ cần, không cấp "để phòng khi cần". Việc nào phải có người duyệt và ở ngưỡng nào là chuyện quyền quyết định, đã được phân tích ở bài trước.
Định kỳ kiểm thử và giám sát sai sót
Hằng tháng, người phụ trách từng mảng dữ liệu kiểm tra một mẫu câu trả lời thật. Trước mỗi lần thay đổi dữ liệu hay phân quyền, cần có người thử các câu hỏi nhạy cảm bằng một tài khoản lẽ ra phải bị từ chối. Mỗi phản ánh của nhân viên đều được phản hồi.
Việc AI được xem những gì là quyết định quản trị, không phải một thiết lập của bộ phận công nghệ.
Những điểm cần thận trọng
Không hệ thống nào an toàn tuyệt đối. Phân quyền giúp giảm rủi ro chứ không xóa bỏ được rủi ro. Dù phân quyền dữ liệu chặt đến đâu, một câu trả lời đúng quyền vẫn có thể sai hoặc bị sao chép đi nơi khác. Mọi lời hứa về an toàn tuyệt đối nên được xem là dấu hiệu cần cảnh giác.
Một bộ dữ liệu chung là điều kiện cần, không phải sự bảo đảm. Nó giải quyết được chuyện một câu hỏi có ba con số. Nhưng nếu dữ liệu chung bị sai, mọi người, kể cả AI, sẽ cùng sai một kiểu và cùng một lúc. Vì thế, khi dữ liệu được dùng chung, việc giữ cho dữ liệu đúng càng trở nên quan trọng.
Các nguồn dẫn trong bài là khung chuẩn, không phải số đo. NIST và OWASP mô tả rủi ro và cách làm tốt; các nguồn này không đo mức độ thường xuyên của những lỗi trên ở doanh nghiệp Việt Nam, và hiện cũng chưa có số liệu công khai đáng tin cậy về điều đó. Phần pháp lý chỉ là tóm lược, không phải tư vấn pháp lý.
Hướng Viindoo chọn
Một trợ lý AI trả lời trôi chảy vẫn có thể sai hai lần liên tiếp: cộng công nợ của chi nhánh vào trụ sở, rồi trích dẫn mức chiết khấu đã bị thay thế. Đằng sau sự bất đồng giữa kinh doanh và kế toán là một câu hỏi chưa ai chốt: dữ liệu nào, cho ai, theo bản nào. AI càng giỏi thì những lỗi như vậy càng đi xa, vì chúng dễ được tin.
Với Viindoo, phân quyền dữ liệu không phải bước bổ sung sau khi đã có AI, mà là nền móng phải có trước. Doanh nghiệp chỉ kiểm soát được AI khi đã kiểm soát được dữ liệu của chính mình: một phiên bản sự thật chung cho mọi phòng ban, và quy định rõ ràng về việc ai được thấy gì. Nền tảng quản trị doanh nghiệp Agentic AI của Viindoo bắt đầu từ đúng điểm đó: đưa cả doanh nghiệp về một bộ dữ liệu chung, rồi để AI làm việc trong đúng phạm vi mà doanh nghiệp đã đặt cho từng người.
Nhìn qua ba lớp đã nêu trong bài, cách tiếp cận đó trả lời được từng lớp. Ở lớp dữ liệu, số liệu của chi nhánh và trụ sở, chính sách chiết khấu cũ và mới cùng nằm trong một bộ dữ liệu có hiệu lực rõ ràng. Ở lớp câu trả lời, AI làm việc theo nguyên tắc không thấy nhiều hơn người đang hỏi, nên giá vốn và hạn mức công nợ chỉ đến tay những người kế toán trưởng đã cho phép. Ở lớp hành động, việc AI được làm gì sau câu trả lời được quy định theo vai trò và mức phê duyệt, như với mọi nhân viên.
Với nhân viên bán hàng, phần phân quyền dữ liệu này gần như vô hình: họ vẫn hỏi AI như bình thường và nhận về đúng phần mình được phép thấy, không phải chờ kế toán. Viindoo đóng vai xương sống ở bên dưới, để việc dùng AI dễ như hỏi một đồng nghiệp, trong khi dữ liệu vẫn ổn định và an toàn.
Không nền tảng nào an toàn tuyệt đối, và cũng không nền tảng nào có thể thay doanh nghiệp quyết định dữ liệu nào là nhạy cảm. Phân loại dữ liệu, đặt quyền xem và rà soát định kỳ vẫn là việc của người quản lý.
Bốn câu hỏi để kiểm tra doanh nghiệp mình
- AI của chúng ta đang thấy những dữ liệu nào, và nó đọc bằng quyền của ai?
- Khi AI trả lời sai, ai sẽ phát hiện, phát hiện bằng cách nào và mất bao lâu?
- Khi giá, chính sách hay quy trình thay đổi, AI thôi dùng bản cũ bằng cách nào?
- Đã có ai thử hỏi AI về lương hay giá vốn bằng một tài khoản lẽ ra phải bị từ chối chưa?
Câu hỏi thường gặp
Đó là tập hợp các quyết định về việc AI được đọc dữ liệu nào, cho ai và để làm gì; doanh nghiệp dựa vào đâu để biết dữ liệu còn mới; và ai kiểm tra câu trả lời. Việc này không cần một đội riêng, nhưng cần có người phụ trách từng mảng dữ liệu và quy định phân quyền rõ ràng.
Còn tùy những câu trả lời còn lại được dùng vào đâu. Sai lịch nghỉ lễ thì thiệt hại nhỏ; nhưng sai hạn mức công nợ hay để lộ lương cho sai người thì thiệt hại lớn. Vì vậy, nên đo riêng độ chính xác, phân quyền và trách nhiệm, theo từng nhóm dữ liệu.
Thường là không. Làm vậy sẽ biến AI thành một cửa sau đi vòng qua quy định phân quyền: ai hỏi được AI cũng chạm được tới mọi thứ tài khoản đó nhìn thấy. Các hướng dẫn bảo mật như của OWASP khuyên cấp quyền ở mức tối thiểu và để AI làm việc trong phạm vi quyền của người dùng.
Có. Luật Bảo vệ dữ liệu cá nhân (số 91/2025/QH15) áp dụng từ ngày 01/01/2026. Nếu AI để lộ dữ liệu của nhân viên hay khách hàng cho sai người, thì đó là doanh nghiệp để lộ dữ liệu. Các nghĩa vụ cụ thể nên được rà soát cùng người có chuyên môn pháp lý.
Bài tiếp theo trong loạt: mọi điều nêu trên đều giả định doanh nghiệp có một AI mà mình nhìn thấy và quản lý được. Nhưng nếu mỗi nhân viên đã tự dùng một công cụ AI riêng, với bản sao dữ liệu công ty của riêng mình, nằm ngoài mọi quy định thì sao? Mỗi nhân viên một AI: Doanh nghiệp có đang tạo ra hệ thống vận hành vô hình?
Nguồn tham khảo
- Viện Tiêu chuẩn và Công nghệ Quốc gia Mỹ - NIST (01/2023). Khung quản lý rủi ro trí tuệ nhân tạo (AI RMF 1.0). NIST AI 100-1.
- Viện Tiêu chuẩn và Công nghệ Quốc gia Mỹ - NIST (07/2024). Khung quản lý rủi ro trí tuệ nhân tạo: Hồ sơ trí tuệ nhân tạo sinh học. NIST AI 600-1.
- Dự án bảo mật OWASP GenAI (2025). OWASP Top 10 cho hồ sơ ứng tuyển chương trình LLM năm 2025: LLM02 Tiết lộ thông tin nhạy cảm, LLM06 Quyền hạn quá trình, LLM08 Điểm yếu về già và nhúng.
- Quốc hội (2025). Luật Bảo vệ dữ liệu cá nhân số 91/2025/QH15, hiệu lực từ 01/01/2026. Tóm lược: Cổng thông tin điện tử tỉnh Hà Tĩnh, 05/01/2026.